Embedl, NVIDIA 자율주행 모델 Alpamayo 2 Edge를 AGX Thor에서 시연
Embedl은 NVIDIA의 자율주행 모델 Alpamayo 2 Edge를 AGX Thor에서 실행하는 웹 시연을 제공합니다. Embedl 자체 시험에서 기록 주행 클립의 GPU 입력부터 궤적 생성까지 중앙값 지연은 56.9ms로 PyTorch BF16 기준선보다 약 10.6배 짧았으며, 요청 왕복 중앙값은 119.5ms, 시연 처리량은 초당 7.9회였습니다.
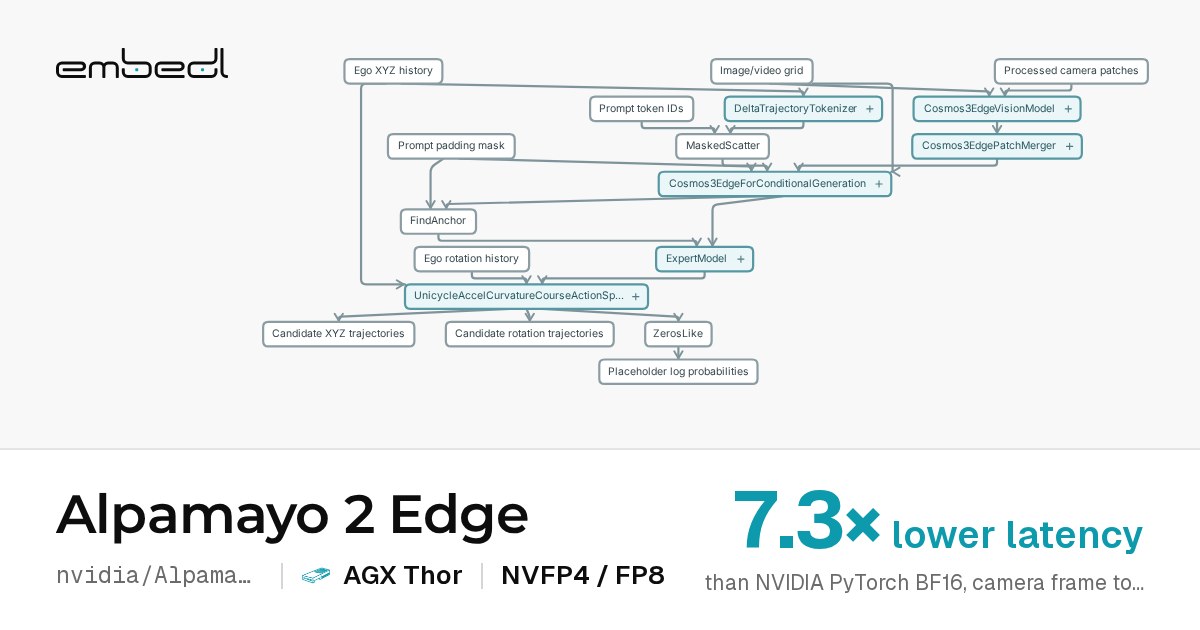
Embedl은 NVIDIA의 자율주행 모델 Alpamayo 2 Edge를 AGX Thor에서 실행하는 웹 시연 페이지를 운영합니다. NVIDIA 개발자 블로그는 2026년 11월 10일 모델 소개와 함께 Embedl 사례를 전했습니다. Embedl의 공동창업자 겸 CEO 한스 살로몬손은 초기 접근을 받은 뒤 48시간 안에 AGX Thor에서 초당 10회 판단을 실행했다고 밝혔습니다.
Alpamayo 2 Edge는 주변 영상과 차량의 이동 이력, 내비게이션 지시를 함께 받아 판단 근거를 설명하는 텍스트와 미래 주행 궤적을 만드는 모델입니다. 입력에는 여섯 카메라에서 서로 다른 시점에 촬영한 영상 22개와 차량의 위치·방향 이력 20개가 들어갑니다. 이 이력은 현재 시점까지 0.1초 간격으로 약 2초를 담습니다. 모델은 여기에 경로 안내 문구를 더해 다음 주행 계획을 계산합니다.
모델 카드에 따르면 궤적은 0.1초 간격의 64개 지점으로 구성돼 최대 6.4초 앞까지 이어집니다. NVIDIA는 모델이 모든 상황에서 긴 판단 문장을 생성하는 대신, 일상적인 주행으로 판단한 경우에는 <NOMINAL> 표식을 출력해 불필요한 추론량을 줄이는 방식도 사용한다고 설명합니다. 모델 개발 과정에는 시뮬레이션에서 행동의 결과를 되돌려 받아 학습하는 폐루프 강화학습도 포함됐습니다.
Embedl의 AGX Thor용 빌드는 NVFP4·FP8 정밀도와 TensorRT Edge-LLM 0.10.1을 사용합니다. Embedl은 여기에 자체 양자화, 캐시, 추측 디코딩을 더했습니다. 비교 기준은 NVIDIA가 공개한 PyTorch 코드와 BF16 가중치를 같은 기기와 입력에서 실행한 결과입니다. 따라서 두 수치의 차이는 한 가지 최적화만의 효과가 아니라 여러 변경을 묶은 Embedl 빌드와 NVIDIA 기준선의 차이를 보여줍니다.
Embedl은 PhysicalAI-AV 주행 기록 한 편에서 판단 180회를 연속 처리하고 처음 10회는 제외해 지연을 측정했습니다. 이 측정의 모델 지연은 입력이 GPU에 올라간 뒤 궤적이 나올 때까지입니다. Embedl 빌드의 중앙값은 56.9ms, 90백분위는 82.7ms였습니다. 같은 조건에서 NVIDIA PyTorch BF16 기준선의 중앙값은 603.7ms였습니다. 중앙값을 비교하면 Embedl 빌드의 모델 지연이 약 10.6배 짧았습니다.
같은 실행에서 요청을 보낸 뒤 기기에서 응답을 받을 때까지의 중앙값은 119.5ms, 90백분위는 147.1ms였습니다. 이 값에는 요청 해독도 포함됩니다. 따라서 56.9ms는 서비스 요청 전체가 아니라 GPU 입력 이후 모델이 궤적을 만드는 구간의 측정치입니다. Embedl 페이지가 10Hz 실시간 시연으로 소개한 실행의 처리량은 초당 7.9회였습니다. 말로 판단 근거를 만드는 결정에는 약 100ms가 걸려 일부 입력 프레임을 건너뛴다고 Embedl은 설명합니다.
Embedl은 자체 데이터로 미세 조정할 수 있는 최적화 모델과 하드웨어·센서·주행 상황에 맞춘 구성을 영업 문의를 통해 제공합니다. NVIDIA 모델 카드에는 가중치 라이선스가 OpenMDW-1.1, 소스 코드 라이선스가 Apache 2.0으로 기재돼 있습니다.