중국 AI 모델 6종 가중치에서 블랙웰 초기화 흔적 발견
Unemployment Labs의 Will DePue는 중국 AI 기업 네 곳의 모델 6종에서 NVIDIA Blackwell GPU로 가중치 초기값을 만들 때 나타나는 패턴을 찾았다고 보고했습니다. 이 흔적은 초기화 장치의 단서이며, 전체 학습에 쓰인 장비나 GPU의 위치, 수출통제 위반 여부까지 보여주지는 않습니다.
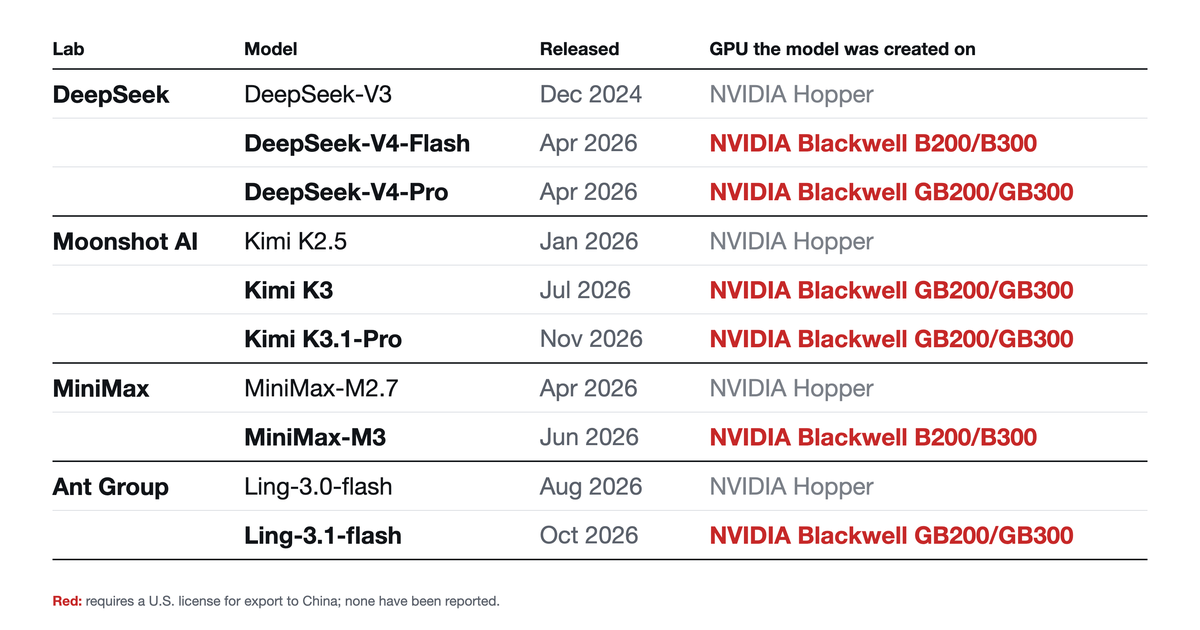
Unemployment Labs의 Will DePue는 DeepSeek, Moonshot AI, MiniMax, Ant Group이 공개한 모델 6종의 가중치에서 NVIDIA Blackwell GPU로 초기값을 만들 때 나타나는 배열 패턴을 찾았다고 보고했습니다. 이 흔적은 학습 시작값을 만든 GPU 구성을 가리킵니다. 모델 전체 학습에 같은 GPU가 쓰였는지, 장비가 중국에 있었는지는 가중치만으로 확인할 수 없습니다.
모델 가중치는 답을 만들 때 쓰이는 수십억 개의 숫자입니다. 학습은 이 숫자를 조정하는 과정이며, 학습을 시작하기 전에는 각 숫자에 초기값을 넣습니다. DePue가 살펴본 PyTorch 프로그램은 Philox라는 의사난수 생성기를 사용합니다. 이 생성기는 seed라는 시작 숫자와 설정이 같으면 같은 숫자열을 만듭니다. 덕분에 엔지니어는 같은 조건에서 실험을 다시 시작할 수 있습니다.
PyTorch는 숫자열을 GPU의 여러 병렬 작업자, 즉 스레드에 나눠 계산합니다. DePue가 검토한 NVIDIA 구성은 충분히 큰 초기화 작업에서 연산 단위인 SM마다 2,048개 스레드를 사용합니다. 이에 따라 Hopper 계열 H100·H200·H800은 132개 SM과 270,336개 스레드를, Blackwell B200·B300은 148개 SM과 303,104개 스레드를, GB200·GB300은 152개 SM과 311,296개 스레드를 사용합니다. seed가 같아도 스레드 수가 달라지면 같은 숫자가 가중치 배열의 다른 위치에 놓입니다. 따라서 배열에 초기화 당시의 GPU 구성 흔적이 남을 수 있습니다. 이 분석으로 좁힐 수 있는 것은 GPU 세대와 구성까지이며, Hopper 지문으로는 H800과 H100, H200을 서로 구별할 수 없습니다.
학습 뒤에도 초기값의 흔적 일부가 남을 수 있습니다. 학습 중 한 번도 등장하지 않은 단어나 기호에 해당하는 임베딩 행은 바뀌지 않아 초기값을 거의 그대로 보존할 수 있습니다. 학습으로 바뀐 가중치에도 초기값의 영향이 약하게 남는 경우가 있습니다. DePue는 후보 seed와 스레드 배열을 공개 가중치에 대조해 가장 잘 맞는 조합을 찾은 뒤, 조합 탐색에 쓰지 않은 별도의 가중치로 다시 검사했습니다. 이미 찾은 숫자만 우연히 맞아떨어진 경우와 구분하기 위해서입니다.
보고서에 따르면 DeepSeek-V3의 보존된 값은 Hopper 배열과, DeepSeek-V4-Flash의 값은 Blackwell의 148-SM 배열과 맞았습니다. DePue는 보고서에서 찾은 seed를 사용해 H100으로 V3의 보존된 값 57,344개를 비트 단위까지 재현했고, B300으로 V4-Flash의 선택된 469개 행을 검사했습니다. 이 가운데 461개 행은 생성값과 상관도가 0.99를 넘었고, 445개 행은 비트 단위까지 같았습니다. 대여한 GB200에서는 Kimi K3의 보존된 13개 행을 재현했습니다. 하드웨어를 공개한 24개 모델의 사례에서도 분석 결과는 공개 정보와 일치했습니다. 다만 관련 모델과 초기화 단계의 체크포인트가 포함돼 있어, 보고서는 이를 정확도 측정치가 아닌 공개 하드웨어 정보와의 일관성 점검으로 제시했습니다.
Blackwell 배열과 맞은 모델은 DeepSeek-V4-Flash와 V4-Pro, Moonshot AI의 Kimi K3와 K3.1-Pro, MiniMax-M3, Ant Group의 Ling-3.1-flash입니다. V4-Flash와 MiniMax-M3는 148-SM 배열에, 나머지 네 모델은 152-SM 배열에 맞았습니다. Kimi K3.1-Pro는 K3와 같은 seed를 사용했습니다. DePue는 이를 K3에서 이어진 후속 체크포인트일 가능성으로 설명했습니다. 앞선 모델 가운데 DeepSeek-V3, Kimi K2·K2.5, MiniMax-M2.7, Ling-3.0-flash는 Hopper 배열과 맞았습니다. Kimi K2.7-Code는 예외입니다. 보존된 254개 행에는 K2.5에서 이어진 Hopper 배열 값이 약 80%, 새로 만든 148-SM 배열 값이 약 20% 섞여 있었습니다. 보고서는 이 패턴을 여러 하드웨어에서 학습한 결과보다 체크포인트를 합친 사례로 해석해, Blackwell 흔적을 보인 6종에 포함하지 않았습니다.
보고서는 공개 가중치에서 배열 흔적을 읽을 수 있었던 일부 중국 AI 모델을 다뤘습니다. 분석 가능한 Alibaba, Zhipu, Tencent, Xiaomi, StepFun의 최신 모델은 Hopper 배열과 맞았습니다. Meituan의 LongCat-2.0에서는 NVIDIA 지문을 찾지 못했습니다. 지문이 발견되지 않은 경우에는 그 사실만으로 사용한 GPU를 특정할 수 없습니다.
Blackwell과 같은 배열을 만드는 다른 GPU 가능성도 검토했습니다. AMD MI300X는 보통 304개 연산 단위를 사용하지만, 148개나 152개만 쓰도록 구성할 수 있습니다. DePue는 실제 MI300X에서 이런 배열을 재현한 뒤 NVIDIA와 AMD의 난수 계산이 다른 값을 비교했습니다. DeepSeek-V4-Flash에서 비교한 377개 값 가운데 363개는 NVIDIA 결과와 맞았고 AMD 결과와 맞은 값은 없었습니다. 나머지 다섯 모델에서는 이 비교로 AMD 가능성을 판별하지 못했습니다. DePue는 그래도 그 설명의 가능성을 매우 낮게 봤습니다.
이 분석이 직접 가리키는 것은 초기값을 만든 GPU입니다. 초기값을 한 시스템에서 만든 뒤 학습을 다른 장비에서 이어가거나, 여러 종류의 GPU를 함께 썼을 가능성은 남습니다. 가중치만으로는 GPU의 위치나 기업이 계산 자원에 접근한 경로를 알아낼 수 없습니다. 보고서는 B200·B300·GB200·GB300을 중국으로 수출하려면 미국 허가가 필요하고 허가 사례는 보고되지 않았다고 적었습니다. Blackwell 시스템은 중국 밖 데이터센터에서 빌릴 수도 있습니다. 가중치 분석은 첨단 GPU에 대한 접근 정황을 보여주지만, 칩의 중국 반입이나 수출통제 위반을 입증하는 근거는 되지 않습니다.